
Day 2 用合成逾時與真實 SQLite,驗證「缺少完成證據時,先核對,不猜測」。今天串接 Gemini 3.8 Flash,但不提供業務工具:以 Google AI Studio 管理 API 金鑰,再透過 Google GenAI SDK,請模型說明固定合成紀錄中的已知與未知。本文保存模型、SDK、輸入、設定、回覆與用量,分開「收到文字」「解讀是否合理」與「服務是否完成」。Antigravity 協助本機審查與執行,作者則核對回覆是否越過事實邊界,並記下未來 LINE 對話需要改善的語氣。
Day 2 tested uncertain outcomes with synthetic timeouts and real SQLite writes. Day 3 uses Gemini 3.8 Flash through the Google GenAI SDK to explain a fixed synthetic service state, without business tools or a LINE integration. The experiment records the model, SDK, input, configuration, visible response, finish reason, and available usage metadata. Human review checks whether the reply preserves uncertainty and suggests an appropriate next step. Receiving text is not proof of correctness, a completed operation, or an accepted human handoff.
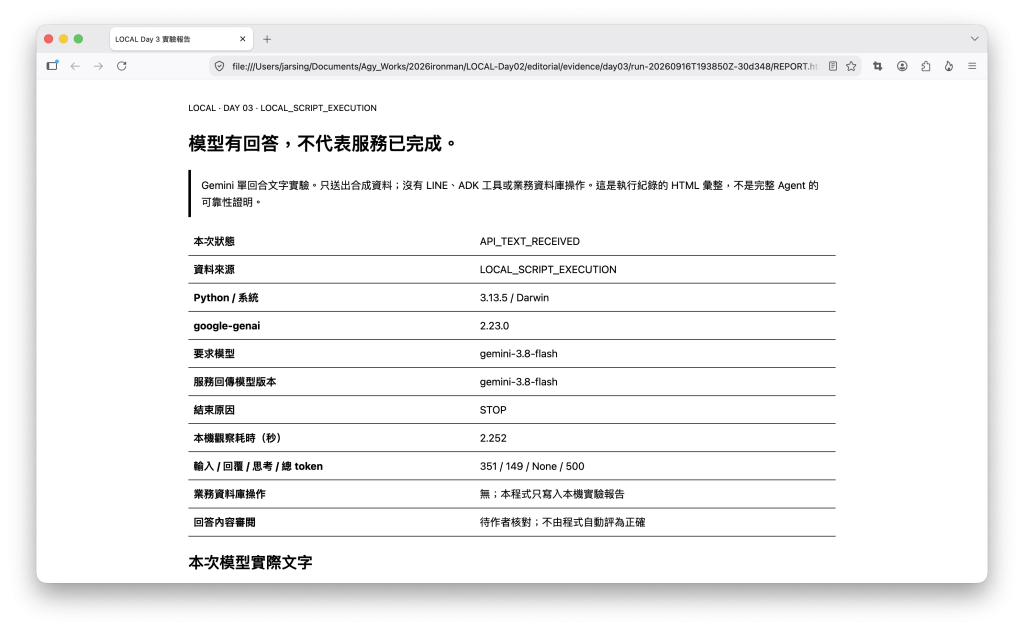
圖 1:LOCAL Day 3 本機實驗報告。這次以 Gemini 3.8 Flash、LOW 思考等級取得一則文字回覆,結束原因為 STOP;報告記錄本機觀察耗時 2.252 秒及服務回傳用量。模型沒有執行工具、LINE 或業務資料庫操作,內容仍由作者審閱。表格中的 None 表示未取得該欄位,不是零。
| 先分開三件事 | 今天怎麼檢查 |
|---|---|
| 程式是否收到模型文字 | 看回覆、結束原因與實際執行紀錄 |
| 模型有沒有合理解讀資訊 | 人工檢查是否保留未知、沒有假稱已操作 |
| 地方服務是不是完成了 | 今天沒有執行任何業務操作,不能宣稱完成 |
昨天的實驗留下兩個事實:工具回報逾時,不足以推論後端成功或失敗;查回請求紀錄,也不等於真人已經受理。
今天把問題往前推一步:如果將同樣的「待核對」狀態提供給 Gemini,它會如何向使用者解釋?
我們仍然使用合成的彰化社區走讀案例。使用者詢問:「剛剛請你幫忙確認無障礙參與需求,現在安排好了嗎?」提供給模型的紀錄只有使用者已確認、工具曾逾時、後端結果仍未知,以及應由後端用原操作識別碼核對的下一步。
這次不是讓 Gemini 真的去核對,而是先看它如何說明已知與未知。 模型即使寫出「我已幫您查詢」,也不代表程式真的查了資料庫。本篇沒有提供工具,也沒有執行 Day 2 的寫入流程。
這樣的範圍刻意小:先建立可記錄、可重跑的模型呼叫,再在後續接 LINE、ADK 與受控工具。否則模型、訊息入口和資料庫同時加入,一旦結果不對,反而難以判斷是哪一層出了問題。
延續 Day 2,今天的最小實驗 Harness 是:固定合成輸入 → 明確的模型與設定 → 一次受控呼叫 → 保存原始文字 → 人工核對。 它是一個方便重跑與檢查的小環境,不是完整 Agent,也不是加上一句提示詞就保證模型可靠。
這三者不是同一件事。
Google AI Studio 是這次取得與管理 Gemini API 金鑰的入口;專案、模型與使用條件依實際帳號設定核對。官方快速入門與金鑰文件提供相關操作方式。[1][2]
Gemini API 是 Python 程式真正呼叫的模型服務。Antigravity 則是協助我讀檔案、檢查計畫、執行與核對結果的開發工具,不是 LOCAL 對外服務的一部分。
本例使用官方推薦的 google-genai 套件,而不是舊的 google-generativeai。[3]
Antigravity:協助本機開發與驗證
Google AI Studio:管理模型服務的使用入口與金鑰
Python + google-genai:發出模型請求並記錄結果
Gemini:根據提供的合成資料產生文字
作者:核對回覆、範圍與結論
AI Studio 與 Antigravity 的畫面顯示「完成」,不能直接代替 API 的執行紀錄。反過來說,一個正常的 API 回覆也不能代替作者對文字內容的判斷。
本次實際要求的模型為 gemini-3.8-flash,服務回傳的 model_version 也是同一個識別。它在本次查證時列於官方穩定模型清單。[4]
初始範例採用 gemini-3.5-flash 與 MINIMAL,這次改用 3.8 時,也同步把思考等級改為 LOW。官方 GenerateContent 思考設定表列出:3.8 Flash 支援 low,不支援 minimal。不能只換模型名稱,卻把上一個模型的參數原封不動帶過去。[6]
這是一次更換模型與相容參數後的實驗,不是 3.5 與 3.8 的效能或穩定性比較。 若讀者改用其他模型,也必須記下真正送出的設定,不沿用舊執行紀錄。
API 採用 SDK 的 client.models.generate_content(),API 版本設定為 v1beta。本篇沿用這次實際取得結果的 GenerateContent 路徑;即使在其他文件看到 Interactions API,也不要直接把另一套介面的參數混進本例。呼叫方式可對照 Google GenAI Python SDK 與 GenerateContent 官方參考文件。[5][9]
安裝檔列出 google-genai>=2.0.0,<3.0.0 作為候選版本範圍,不代表這個範圍內的每個版本都已驗證,也不是完整的相依套件鎖定。本次實際版本是 google-genai==2.23.0,報告另記錄 httpx 與 pydantic 版本。
範例產生的 sdk-version.txt 只固定 SDK 版本;要完整重建環境,還需要保存其餘相依套件與執行環境。即使條件盡可能相同,仍不能保證模型日後輸出逐字一致。
重現這裡指的是:知道用什麼輸入與條件重新做同一個實驗,並能解釋差異;不是宣稱機率式模型一定吐出同一段文字。
case.json 是固定的合成輸入,其中的核心狀態是:
{
  "user_confirmed": true,
  "operation_state": "pending_verification",
  "tool_result": "timeout",
  "stored_request": "unknown"
}
這是 LOCAL 自訂的資料,不是 Google 的官方 payload,也不是從正式使用者系統取得的紀錄。
指示要求模型用繁體中文與臺灣慣用語,說明目前能確認什麼、不能確認什麼,以及下一步應如何核對;同時告知它沒有工具或後端存取權限。
我沒有預先寫一段「標準漂亮回答」塞進展示,也沒有要求程式比對某一個固定句子就判定正確。今天的重點,是保留實際回覆,再依狀態核對含義。
這可以看成最小的上下文安排:只給當前問題需要的狀態,不把整段歷史、整個資料庫或開發金鑰都交給模型。 完整的 Context Engineering 與記憶治理留待後續,但邊界從第一個回合就要清楚。
本例將最重要的生成設定固定下來。以下是呼叫核心的節錄;SYSTEM、record、args 與 client 的建立方式見完整程式,不是可獨立執行的片段:
config = types.GenerateContentConfig(
    system_instruction=SYSTEM,
    max_output_tokens=2048,
    thinking_config=types.ThinkingConfig(
        thinking_level=types.ThinkingLevel.LOW
    ),
    automatic_function_calling=types.AutomaticFunctionCallingConfig(
        disable=True
    ),
)

result = client.models.generate_content(
    model=args.model,
    contents=record["prompt"],
    config=config,
)
這段是實驗程式的核心用法;完整的金鑰讀取、例外處理與結果保存請見 Repo。設定 LOW 是本次使用的思考等級,不等於關閉思考。max_output_tokens=2048 是生成上限,不是要求一定產生 2,048 個 token,也不代表取得這麼長的使用者可見文字。沒有提供 tools,並停用自動函式呼叫。[5][6]
此外,HTTP 逾時設為 60,000 毫秒,SDK 重試選項為 HttpRetryOptions(attempts=1);本例沒有自行重試、切換模型或連續呼叫的迴圈。--live 是明確執行真實 API 的開關。[5]
「這份紀錄有一次生成呼叫」,不等於今天只執行過一次程式。 人工決定再試或換模型時,應另存一份執行紀錄。這些限制用來控制單次實驗,不是整個 Google 帳戶的費用上限,也不表示逾時就一定沒有費用。[8]
本篇不設定 temperature 為零來宣稱「完全可重現」,也不降低安全設定。單次呼叫的 token 上限與當次耗時,無法推導正式服務的長期費用與延遲分布。
我使用 Antigravity GUI 協助審查、執行與核對。程式放在本機 Repo 的 examples/day03/;文章與證據則留在 Repo 外的 editorial/。先限定「只處理 Day 3、保留 Day 1/2、不 push、不部署」,再檢查計畫與修改內容。Antigravity 的 Implementation Plan 提供計畫審閱與批註的工作方式。[7]
對這個實驗來說,先確認 Agent 操作的是預期的本機資料夾,比找到特定名稱的介面選項更重要。我不把 Local Mode 選單當成本篇的必要步驟,也不為了執行範例另外建立工作副本。
讀者可以在已選定的 Python 環境安裝相依套件,並先跑離線檢查:
python3 -m pip install -r examples/day03/requirements.txt
python3 -m unittest discover -s examples/day03 -p test_run.py -v
建議用獨立虛擬環境,不為這篇更換整台電腦的 Python 版本。範例提供 18 項離線邏輯測試,涵蓋合成資料標示、金鑰缺漏、回覆截斷、未知用量、非文字內容、HTML 特殊字元的跳脫處理與未核准不呼叫等。
18 是範例中的測試案例數,不是下方模型執行報告記錄的通過數。 離線測試使用替身資料,應另存測試輸出;它們不是 18 次 Gemini 成功呼叫,也不能拿來計算模型回答正確率。
取得本人允許使用的 API 金鑰後,把它保存在 Repo 外的私人 .env,內容只需要 GEMINI_API_KEY=...。若已設定同名環境變數,本例會優先使用它;程式明確傳入這個值,不自動採用另一個 GOOGLE_API_KEY。不要把金鑰貼入聊天、文章、截圖或 Git。[2]
確認帳務與當次實驗授權後,再執行一次:
python3 examples/day03/run.py --live \
  --model gemini-3.8-flash \
  --env-file ../editorial/private/.env \
  --output ../editorial/evidence/day03
以上是「Repo 與 editorial 位於同一外層資料夾」的相對路徑示範;實際位置不同就改成對應路徑,不能照抄後讀到別的專案。
Gemini Developer API 與主辦提供的 Cloud 抵用金是否相容,仍以該券適用範圍和帳戶計費方式為準。免費學習點數不是 API 金額;本篇也不因取得資源就宣稱模型免費。[8]
每次執行會建立新的 run-... 資料夾,保存 verification.json、response.txt、CHATGPT_HANDOFF.md 與 REPORT.html,不覆蓋前一次失敗紀錄。
我會分開看三種資料:
| 類別 | 紀錄內容 | 能支持什麼 |
|---|---|---|
| 實驗條件 | 要求模型、SDK、API 介面、Prompt、設定、程式雜湊 | 知道這次如何執行 |
| 模型服務回覆 | 可見文字、回傳模型版本、結束原因、用量 | 知道這次回了什麼 |
| 人工判斷 | 是否保留未知、是否假稱已執行、下一步是否合理 | 對這一則回答作有限審閱 |
服務未提供的用量欄位保持未知,不填成零。max_output_tokens 是設定上限,不是實際用量;本機量到的單次耗時也不是模型基準測試。
API_TEXT_RECEIVED 是本程式自訂的狀態:已收到非空文字、結束原因為 STOP,而且沒有記錄到本例排除的非文字內容或提示詞封鎖原因。這是回覆格式與結束狀態的基本檢查,不是 Google 提供的「答案正確」分數,也不是後端完成憑證。
即使結束原因正常,模型仍可能說錯。若回答不理想,就保留並分析它;不要偷偷換一句人工寫好的答案,繼續叫它模型的實測結果。
本次紀錄為 API_TEXT_RECEIVED,error 為 null,並保存了一則模型文字。以下數據只對應這一份執行紀錄;不是所有嘗試的彙總,也不是全面正確率。
| 項目 | 本次紀錄 |
|---|---|
| 紀錄時間(臺灣,UTC+8) | 2026/09/17 03:38:50 |
| 原始時間(UTC) | 2026-09-16T19:38:50.059571+00:00 |
| 系統/Python | Darwin / 3.13.5 |
google-genai |
2.23.0 |
httpx/pydantic |
0.28.1/2.13.5 |
| 要求模型 | gemini-3.8-flash |
| 服務回傳模型版本 | gemini-3.8-flash |
| API 介面/版本 | Gemini Developer API/GenerateContent/v1beta |
| 思考等級 | LOW |
| 輸出上限 | 2,048 token |
| 本份紀錄的生成呼叫次數 | 1 |
| 本次狀態 | API_TEXT_RECEIVED |
| 結束原因 | STOP |
| 本機觀察耗時(秒) | 2.252 |
| 輸入 token | 351 |
回覆 token(candidates_token_count) |
149 |
思考 token(thoughts_token_count) |
null:未提供/未知 |
快取內容 token(cached_content_token_count) |
null:未提供/未知 |
| 總 token | 500 |
2.252 秒是這次程式觀察到的單次呼叫耗時,不是模型純運算時間,也不是延遲分布。 149 是回覆 token 數,不是 149 個中文字;思考與快取欄位的 null 仍保持未知,不能補成零。
本次模型可見文字(原文):
您好,關於您詢問的彰化社區走讀活動無障礙需求,目前狀況如下:

* **目前已知**:您先前已送出確認,但系統處理逾時,目前的狀態為「待核對」。
* **尚無法確認**:我不具備系統存取權限,因此目前無法確認您的需求是否已成功保存、真人團隊是否已受理,以及活動現場是否能配合提供協助。
* **建議下一步**:本文字介面無法替您執行操作,需由具權限的後端系統或工作人員依原單號進行查詢與核對,請稍候專人確認或向主辦單位進一步洽詢。
作者對這一則回覆的第一輪判讀:
模型文字嚴格守住未知邊界,未給予虛假承諾;條列式說明雖然清晰,但未來接上 LINE 對話介面時,語氣可進一步調整得更口語親切。
這段判讀聚焦在:回答保留了「待核對」,也沒有宣稱請求已保存、真人已受理或現場已安排協助。這是對這一則回答的人工觀察,不是完整模型評測。
進一步檢查原文,最後一句「請稍候專人確認」值得留意:雖然沒有宣稱已經處理完成,讀者仍可能理解為「現在已有人會來處理」。但本次輸入並未確認真人接手,程式也沒有發出通知。未來調整 LINE 用語時,不只是讓文字更親切,也要避免暗示尚未成立的後續服務承諾。
原文的「原單號」同樣需要對照系統設計。本次輸入提到的是由後端使用原操作識別碼核對,不代表使用者手上一定已有可查詢的單號;對外措辭不能直接把內部識別方式當成使用者已知資訊。
語氣可以更親切,但不能因此多出一個事實、一個操作,或一項尚未成立的承諾。 上述是根據原文提出的後續改進方向,尚未提供調整後回答的實測紀錄;模型原文保持不變。
原始報告中的 content_review: "not_recorded" 與 published: false,描述的是程式產生紀錄時的狀態。作者在執行後的判讀另記於本文,不回改原始報告。
金鑰未設定、SDK 未安裝、權限不足、模型不可用、配額限制,都與「模型回答不好」不同。程式將未開始的設定阻擋、API 錯誤與需要人工檢查的回覆分開標示,不用同一句「失敗了」抹平原因。
回覆被截斷或沒有可見文字,不當成正常回答。遇到 429,先核對配額與使用條件;遇到 503,只能先記為服務暫時不可用,不能僅憑這個狀態碼斷言確切故障原因。http_code: null 則表示沒有記錄到狀態碼,要搭配執行階段與例外類型判讀。[10]
沒有用量資料不代表沒有費用,也不能因此連續重跑。若人工決定換模型或稍候再試,保留前一次紀錄,新結果另存;不能只留下成功那一次,再宣稱原設定一路成功。
錯誤報告只保留必要類型、狀態與提示,不直接印出整個例外本文或 HTTP header,以免金鑰與私人資訊進入分享資料。HTML 報告則對模型文字中的特殊字元做跳脫處理,以文字呈現,不直接當成 HTML 執行。
這些都是小型實驗的防線,不等於已完成正式服務資安審查。
今天的 LOCAL 尚未使用 ADK 編排、LINE webhook、向量資料庫或真人交接;也沒有把模型回答拿去執行 shell、SQL 或資料寫入。程式只把合成輸入送到 Gemini,並在本機寫入實驗紀錄。
這份結果支持的是:在本次環境、輸入與設定下,程式收到一則可供審閱的 Gemini 回覆;作者確認它沒有直接假報服務完成,也提出用語上的改進方向。它不能證明所有同類需求都會正確,更不能證明無障礙服務已安排。
本文也沒有提供完整的多模型比較、多次抽樣、正式成本分析或 LINE 使用者測試資料。LOW、單次耗時與這一則文字,都不能單獨支持「3.8 比 3.5 更好」的結論。
這正好接回 Day 2:模型可以協助說明狀態,卻不能憑文字改寫後端事實。 未來接上工具,仍須保留確認、身分、狀態與執行證據,不因模型更聰明就把它們拿掉。
下一篇把已記錄的模型回合接到 LINE:先驗證 Webhook 來源,再處理輸入、模型呼叫與回覆。這次保存的案例、設定與失敗紀錄,將成為後續整合的起點。
Day 1 問什麼才叫完成,Day 2 用後端實驗區分未知與事實,Day 3 則開始檢查模型如何表達這些事實。
第一個模型回合的價值,不只是看到一句回答,而是知道它從哪裡來、根據什麼,以及不能拿它證明什麼。
LOCAL 專案 中,本篇程式路徑為 examples/day03/,重現文件為 docs/day03/。請配合本文採用的程式版本與執行紀錄閱讀,不用舊紀錄替改過的程式背書。
前篇:Day 2〈AI 說「完成」真的完成了嗎?把 LOCAL 的第一條驗收規格跑起來〉。系列入口:LOCAL:30 天打造 LINE × Google AI 地方服務 Agent。


 iThome鐵人賽
 看影片追技術